
Im Juli hatten wir bereits über einen schwerwiegenden Fehler beim SSD-Cache unserer UGREEN NASync iDX6011 Pro berichtet. Nach einem von UGOS angebotenen SSD-Cache-Upgrade ließ sich das Btrfs-Volume nicht mehr einbinden, obwohl der eigentliche Storage-Pool weiterhin als „Normal“ angezeigt wurde. UGREEN bestätigte uns damals einen Softwarefehler und kündigte die Behebung mit einem kommenden Firmware-Update an. Dieses Firmware-Update ist inzwischen erschienen und auf unserem iDX6011 Pro installiert. Behoben ist das Problem damit allerdings nicht. Ein erneuter Versuch, die beiden verbauten NVMe-SSDs als Lese- und Schreibcache einzurichten, endete wieder mit einem nicht mehr eingebundenen Volume. Dieses Mal konnten wir allerdings deutlich genauer nachvollziehen, was während der Einrichtung des SSD-Caches passiert.

RAID5 bleibt intakt, das Volume verschwindet trotzdem
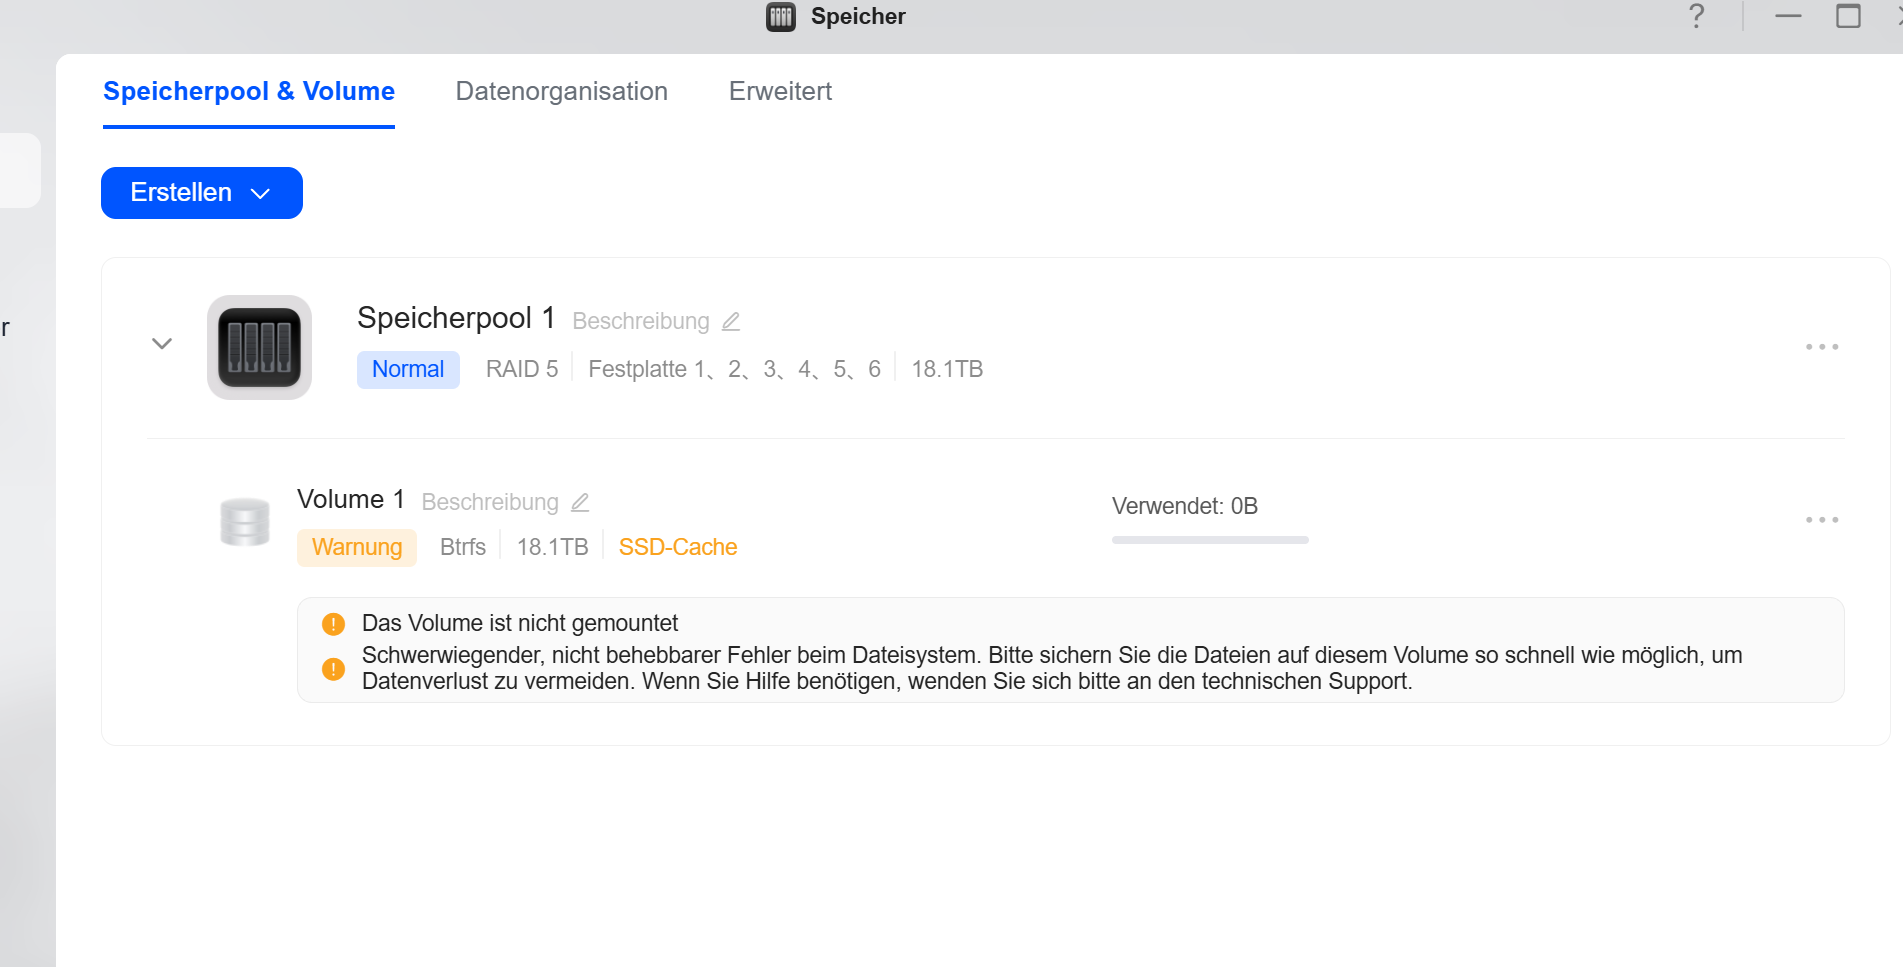
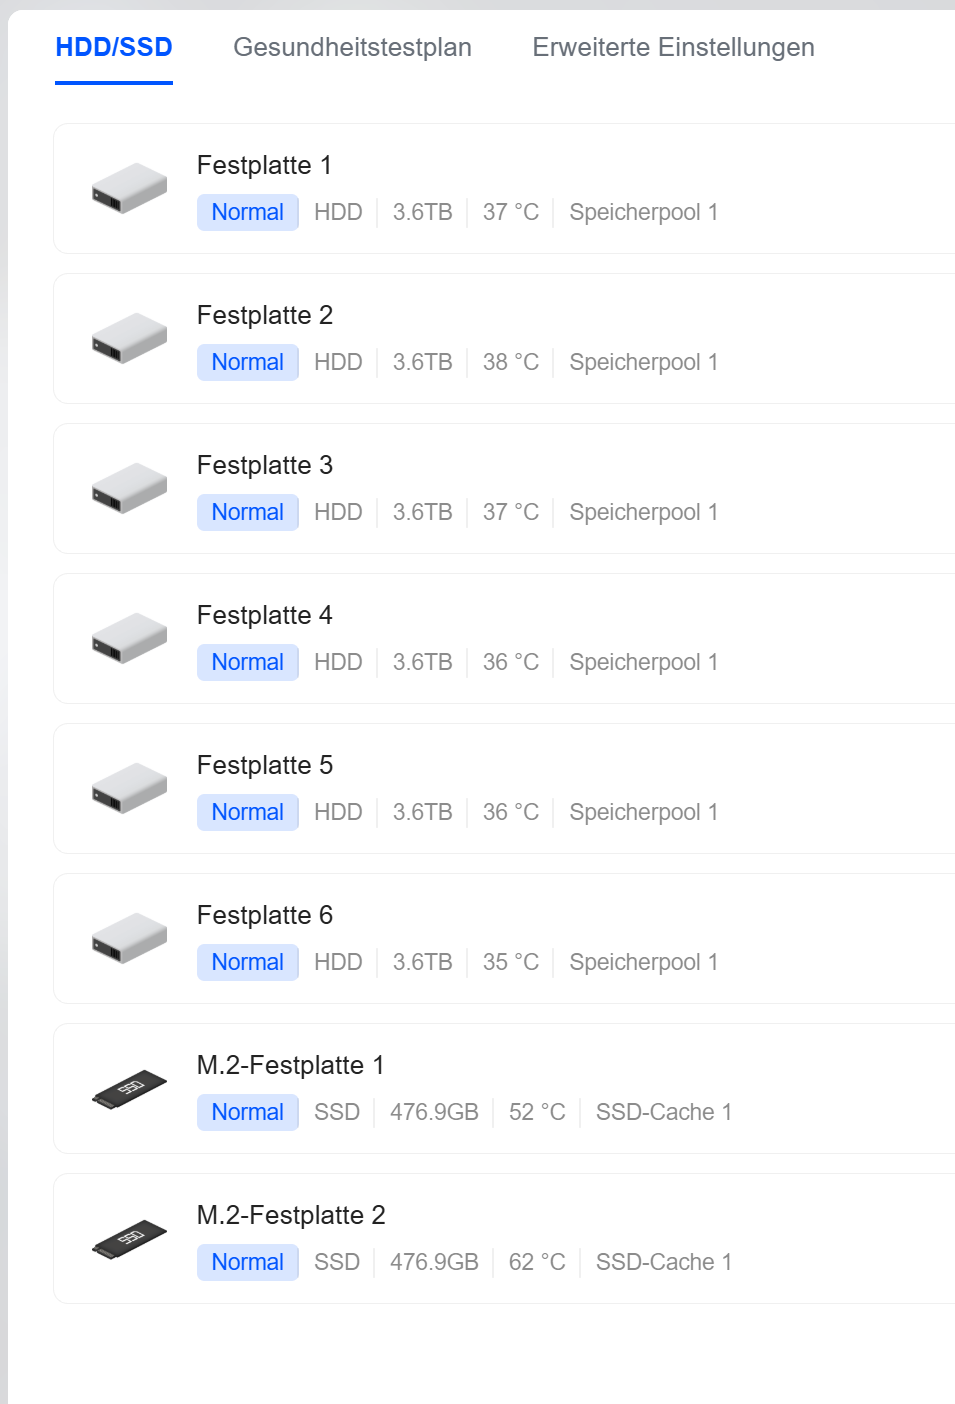
Das Fehlerbild erinnerte zunächst stark an unseren ersten Fall im Juli. Nach der Einrichtung des SSD-Caches meldete UGOS einen schwerwiegenden und nicht wiederherstellbaren Dateisystemfehler. Volume 1 wurde nicht mehr eingebunden, während der eigentliche Storage-Pool weiterhin als „Normal“ angezeigt wurde. Unser aus sechs Festplatten bestehender RAID5-Verbund blieb während des gesamten Vorgangs intakt. Alle sechs Festplatten wurden weiterhin als aktive Mitglieder des Arrays erkannt. Auch das darauf liegende LVM-Volume war vorhanden und hatte nach wie vor seine vollständige Größe.
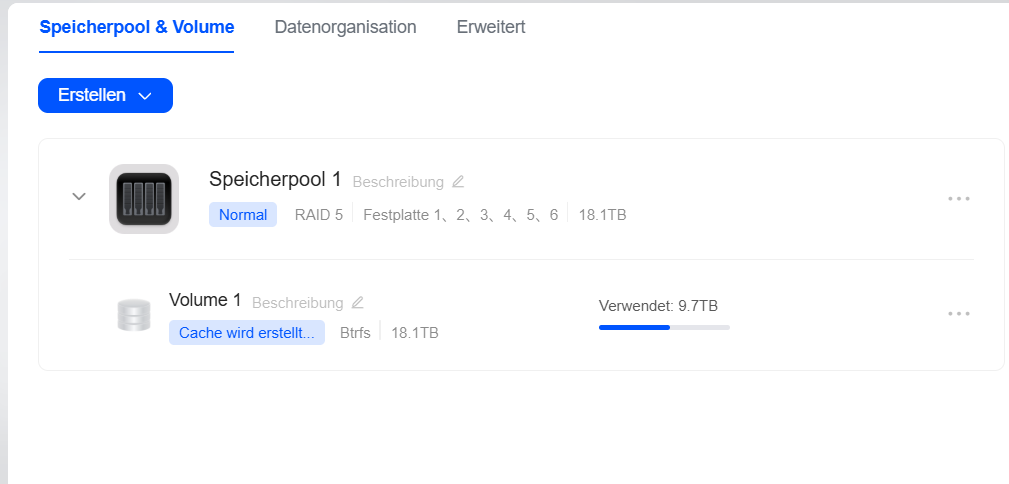
Konkret umfasst das Volume 19.921.329.192.960 Byte, also rund 19,92 TB beziehungsweise 18,12 TiB. Darauf liegt unser Btrfs-Dateisystem mit derzeit rund 9,8 TB belegtem Speicher. Weder der RAID5-Verbund noch das ursprüngliche Volume waren also verschwunden.
Problematisch wurde es erst mit der zusätzlichen Cache-Schicht, die UGOS bei der Einrichtung vor das vorhandene Volume setzte. Für die beiden NVMe-SSDs erstellte das System zunächst einen RAID1-Verbund und darauf die für den SSD-Cache benötigten Strukturen. Anschließend wurde das vorhandene Volume über einen bcache- beziehungsweise Device-Mapper-Pfad bereitgestellt. Genau an dieser Stelle lief etwas schief.
Aus 19,92 TB werden plötzlich nur noch 11,95 TB
Während das ursprüngliche Volume weiterhin exakt 19.921.329.192.960 Byte groß war, stellte der von UGOS erzeugte Cache-Pfad nur 11.952.797.523.968 Byte bereit. Über diese zusätzliche Schicht fehlten damit rund acht Terabyte des eigentlichen Blockgeräts. Die Abweichung ließ sich auch auf Sektorebene nachvollziehen. Das ursprüngliche Volume umfasst 38.908.846.080 Sektoren. Die von UGOS erzeugte Device-Mapper-Schicht bildete davon jedoch lediglich 23.345.307.648 Sektoren ab.
Btrfs selbst erwartet laut Superblock weiterhin ein Blockgerät mit der vollständigen Größe von 19.921.329.192.960 Byte. Beim Zugriff über den erheblich kleineren Cache-Pfad konnte das Dateisystem entsprechend nicht mehr korrekt geöffnet werden. Unter anderem meldete Btrfs nicht lesbare Tree Blocks und brach das Öffnen des Dateisystems schließlich ab. In der Oberfläche von UGOS sah das Ergebnis deutlich dramatischer aus. Volume 1 ließ sich nicht mehr einbinden und wurde mit einer Warnung versehen. Gleichzeitig meldete UGOS einen schwerwiegenden und nicht wiederherstellbaren Dateisystemfehler und empfahl, die Daten des Volumes umgehend zu sichern. Der Storage-Pool selbst blieb dagegen weiterhin auf „Normal“.
Btrfs musste nicht repariert werden
Entscheidend war für uns deshalb, nicht vorschnell eine Reparatur des Btrfs-Dateisystems durchzuführen. Die vorhandenen Daten lagen weiterhin auf dem ursprünglichen RAID5-Verbund. Stattdessen haben wir den fehlerhaften Cache-Aufbau schrittweise aus dem Storage-Pfad entfernt. Nachdem bcache gestoppt und die fehlerhaft dimensionierte Device-Mapper-Schicht entfernt war, stand das ursprüngliche Volume wieder direkt zur Verfügung – und zwar mit seinen vollständigen 19.921.329.192.960 Byte. Eine Reparatur von Btrfs war nicht erforderlich. Das Dateisystem ließ sich anschließend wieder regulär im Lese- und Schreibmodus einbinden. Auch unsere vorhandenen Daten und Verzeichnisse sind wieder zugänglich. Aktuell sind von rund 19 TB nutzbarer Kapazität etwa 9,8 TB belegt, weitere 8,4 TB stehen zur Verfügung. Anschließend haben wir auch den begonnenen SSD-Cache-Verbund vollständig entfernt. Der dafür aus den beiden NVMe-SSDs angelegte RAID1-Verbund wurde gestoppt und die verbliebenen RAID-Metadaten auf den SSDs entfernt. Das produktive Btrfs-Volume läuft damit wieder direkt über den ursprünglichen RAID5-Verbund und ohne vorgeschalteten SSD-Cache.
UGREEN hatte einen Firmware-Fix angekündigt
Besonders interessant ist der erneute Fehler mit Blick auf unseren ersten Bericht vom Juli. Damals analysierte der UGREEN-Support das Problem in einer Remote-Season gemeinsam mit dem Entwicklungsteam. Nach mehreren Eingriffen konnte das Volume wieder eingebunden und auch der SSD-Cache wiederhergestellt werden. Im Anschluss bestätigte uns UGREEN den Softwarefehler und riet ausdrücklich davon ab, das weiterhin angebotene SSD-Cache-Upgrade erneut durchzuführen. Gleichzeitig kündigte der Support die Behebung mit einem zukünftigen Firmware-Update an:
Please do not upgrade the SSD cache, otherwise the same issue will happen again. The issue will be fixed in future firmware update.
Seit dieser Aussage hat UGREEN genau ein Firmware-Update für unser System veröffentlicht. Dieses Update ist auf dem iDX6011 Pro inzwischen installiert. Der angekündigte Fix greift bei unserer Konfiguration allerdings offenbar nicht. Beim erneuten Einrichten des SSD-Caches landete Volume 1 wieder in einem Zustand, in dem es nicht mehr eingebunden werden konnte. Ob technisch exakt dieselbe Ursache wie beim Fehler im Juli dahintersteckt, können wir derzeit noch nicht abschließend feststellen. Das sichtbare Fehlerbild ist allerdings sehr ähnlich. Dieses Mal konnten wir zusätzlich nachweisen, dass UGOS beim Aufbau des SSD-Caches einen Blockgerätepfad erzeugte, dessen Größe erheblich vom eigentlichen Volume abwich.
UGREEN untersucht das Problem erneut
Wir haben UGREEN über den erneuten Fehler informiert und dem technischen Support die entsprechenden Diagnosedaten sowie unsere bisherigen Erkenntnisse zur Verfügung gestellt. Nach Angaben des Supports konnte das Verhalten in der eigenen Testumgebung bislang nicht reproduziert werden. Der Fall wird daher erneut untersucht. Bis zur Klärung haben wir den SSD-Cache auf unserem iDX6011 Pro vollständig entfernt. Das NAS läuft wieder mit dem ursprünglichen RAID5-Verbund und dem darauf liegenden Btrfs-Volume. Die beiden NVMe-SSDs werden derzeit nicht als Cache verwendet. Auf einem bereits betroffenen System würden wir weiterhin davon abraten, den SSD-Cache erneut einzurichten oder ein angebotenes Cache-Upgrade durchzuführen. Unser RAID5 und die darauf gespeicherten Daten haben den erneuten Fehler zwar unbeschadet überstanden, die Wiederherstellung des Volumes erforderte allerdings manuelle Eingriffe auf der Kommandozeile.